2026-11-04
옵저버빌리티(Observability)란?
옵저버빌리티는 시스템이 밖으로 내보내는 신호만으로 내부에서 무슨 일이 일어나는지 설명할 수 있는 능력으로, “처음 보는 문제를 코드 수정·재배포 없이 질문하고 답할 수 있는가?”를 정의한다.
개요 / 배경
- 어원은 제어 이론이다. 1960년 루돌프 칼만이 “시스템의 출력만으로 내부 상태를 추론할 수 있으면 그 시스템은 관측 가능(observable)하다”고 정의했다.
- 소프트웨어에서 출력은 텔레메트리(telemetry), 즉 메트릭·로그·트레이스 같은 신호다.
왜 등장했나
- 요청 하나가 여러 곳을 거쳐 간다: 서버가 하나일 때는 그 서버의 로그만 열어 봐도 대부분 원인을 찾을 수 있었다. 지금은 공고 상세 페이지 하나를 열어도 요청이 브라우저 → CDN → Next.js SSR 서버 → GraphQL 게이트웨이 → DB를 차례로 지나간다. 어느 한 곳의 로그만으로는 요청 전체를 볼 수 없다.
- 장애 원인이 매번 새롭다: 미리 대시보드를 만들어 둘 수 있는 “아는 문제(known unknowns)“보다, 무엇을 봐야 할지조차 모르는 “모르는 문제(unknown unknowns)“가 늘었다.
- 재배포 루프가 비싸다: 새 질문이 생길 때마다 로그 한 줄 추가 → 재배포 → 재현 대기를 반복하면 장애 복구 시간(MTTR)이 길어진다.
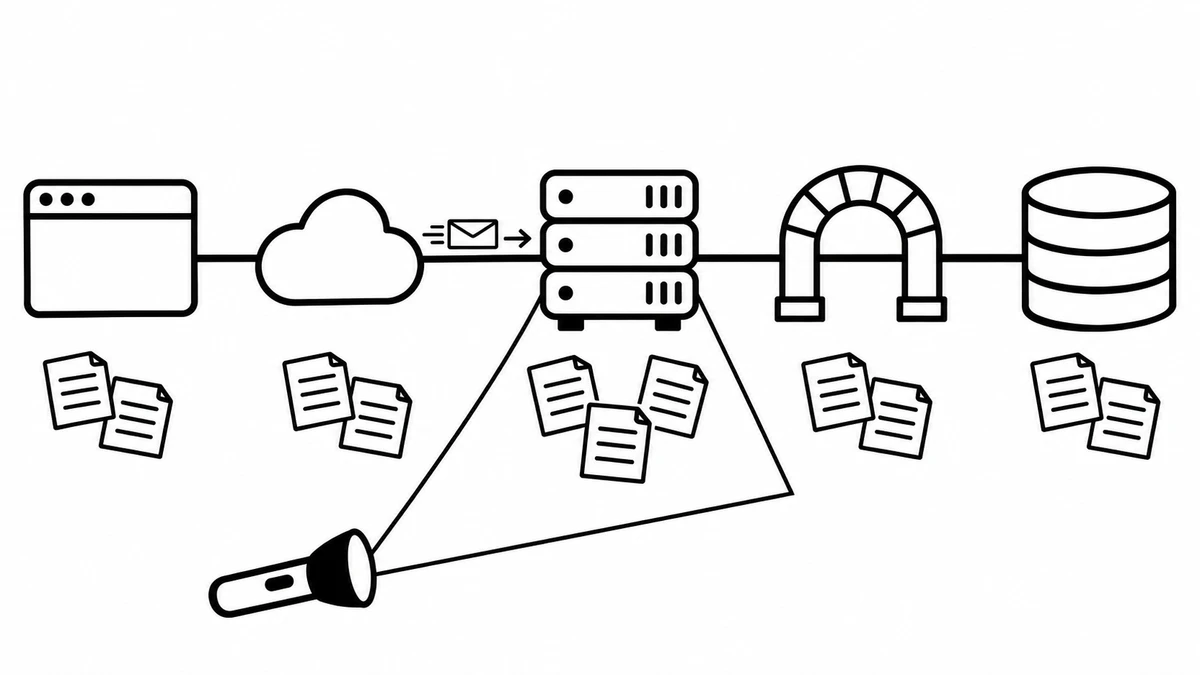
동작 원리
옵저버빌리티는 크게 네 가지 축으로 이해할 수 있다.
- 신호를 남긴다 - 메트릭, 로그, 트레이스
- 신호를 잇는다 -
trace_id와 Context Propagation - 신호를 모은다 - OpenTelemetry
- 기준을 세운다 - SLI / SLO / 에러 버짓
1. 신호를 남긴다: 메트릭, 로그, 트레이스
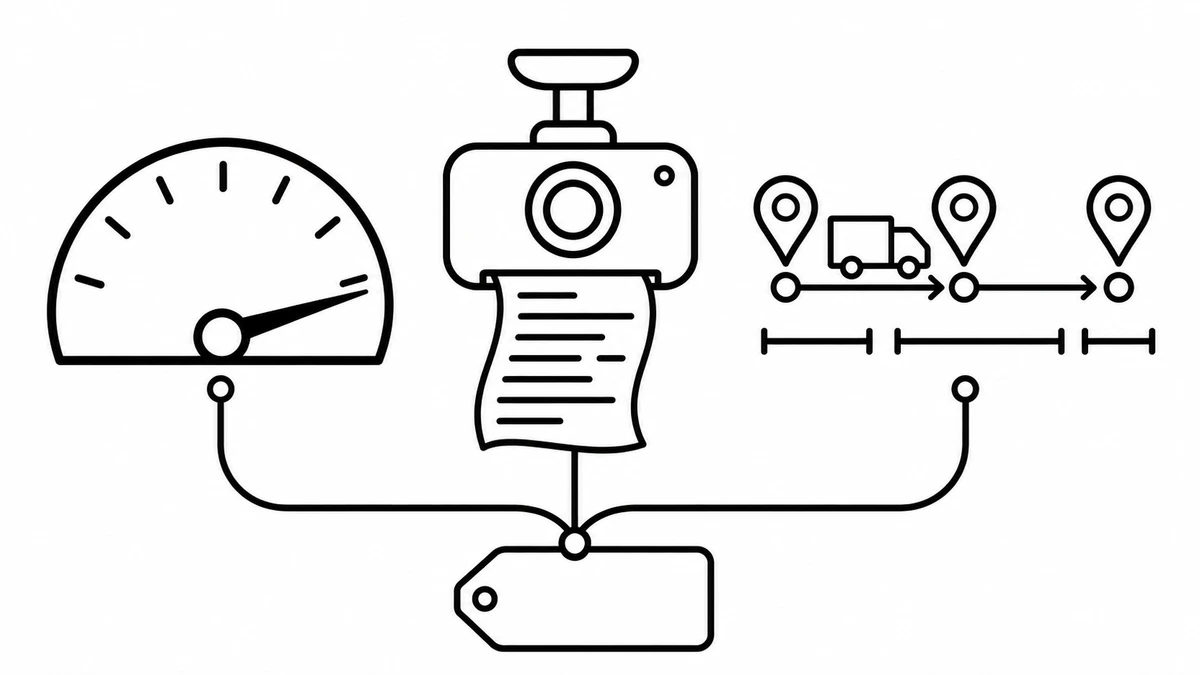
| 신호 | 비유 | 잘 답하는 질문 | 약점 |
|---|---|---|---|
| 메트릭 | 자동차 계기판 | ”평소와 다른가? 얼마나 나빠졌나?” | 집계하면서 개별 요청의 사연이 사라진다 |
| 로그 | 블랙박스 기록 | ”그 순간 정확히 무슨 일이 있었나?” | 양이 많고 비싸며, 여러 서비스에 흩어진다 |
| 트레이스 | 택배 배송 조회 | ”이 요청은 어느 구간에서 시간을 썼나?” | 전부 저장하면 비싸서 샘플링한다 |
- 흔히 세 기둥(three pillars)이라 부르지만, 셋을 따로 쌓는 것만으로는 부족하다. 진짜 힘은 셋이 서로를 가리킬 때 나온다.
- 최근에는 프로파일(함수 단위 CPU·메모리), 이벤트(배포·피처 플래그 변경), RUM(실사용자 브라우저 측정)까지 신호로 다룬다.
2. 신호를 잇는다: Context Propagation
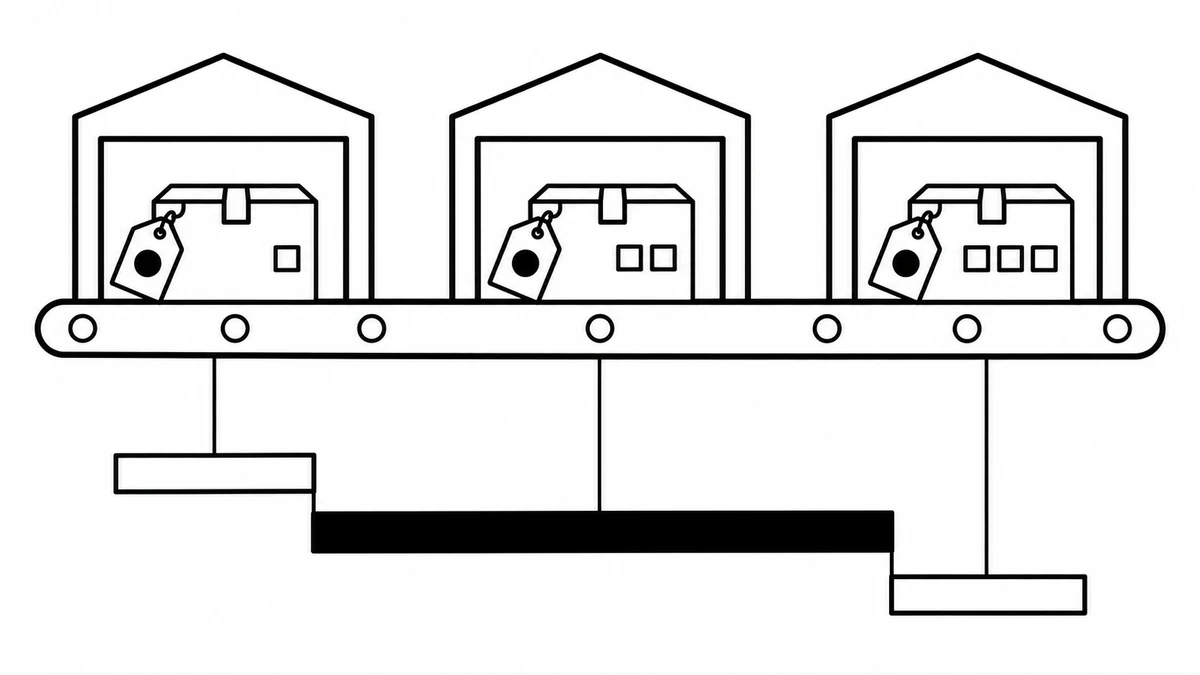
트레이스는 span들의 나무다. span 하나는 “어떤 작업이, 언제 시작해서, 얼마나 걸렸고, 어떤 속성이 있었나”를 담는다.
서비스 경계를 넘을 때는 HTTP 헤더에 “이 요청은 어느 트레이스의 어느 span에서 왔다”는 꼬리표를 붙인다.
표준은 W3C Trace Context의 traceparent 헤더다.
traceparent: 00-4bf92f3577b34da6a3ce929d0e0e4736-00f067aa0ba902b7-01-로 나뉜 네 부분은 각각 이런 뜻이다.
| 순서 | 값 | 이름 | 뜻 |
|---|---|---|---|
| 1 | 00 | 버전 | 헤더 형식의 버전 |
| 2 | 4bf92f35...0e4736 | trace-id | 요청 전체가 공유하는 ID. 서비스를 몇 번 넘어가도 그대로 유지된다 |
| 3 | 00f067aa0ba902b7 | parent span-id | 이 요청을 보낸 span의 ID. 받는 쪽은 자기 span을 이 아래에 매단다 |
| 4 | 01 | 플래그 | 01이면 샘플링 대상이라 기록을 남긴다 |
- trace-id는 송장 번호, span-id는 각 허브의 처리 기록 번호다.
- 같은
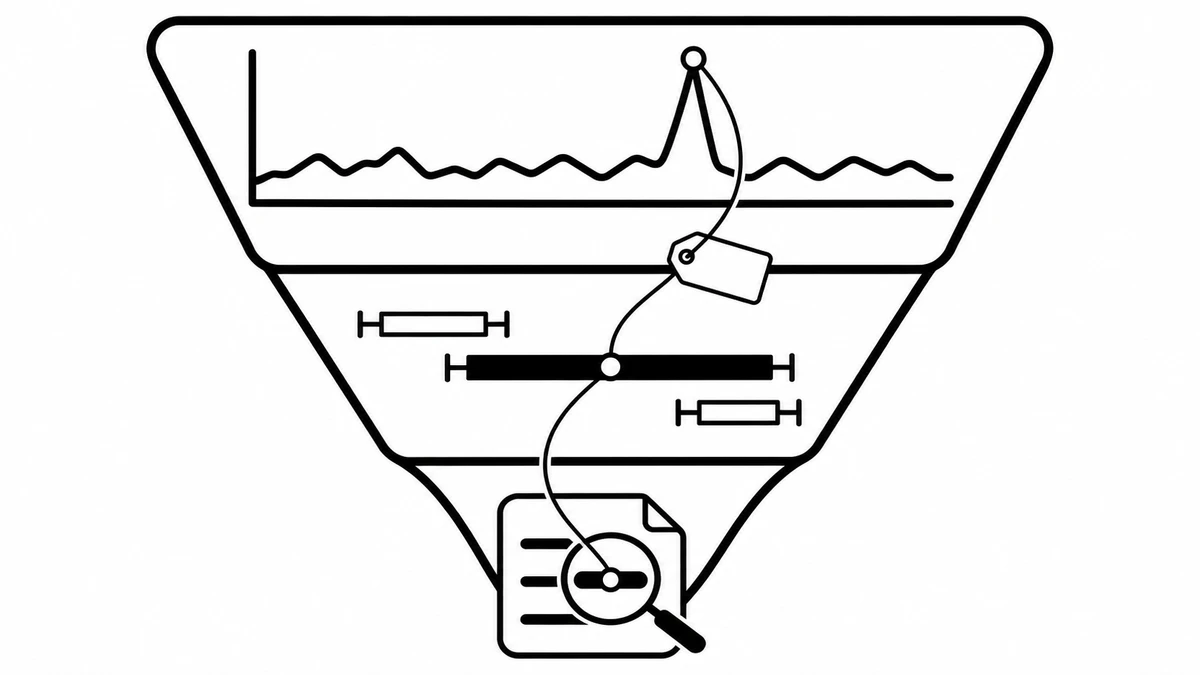
trace_id를 로그 필드에도 넣으면 로그 ↔ 트레이스로 바로 점프할 수 있다. - 메트릭 데이터 점에 대표 trace-id를 붙인 것을 exemplar라 하며, 그래프의 튄 점에서 트레이스로 넘어가는 다리가 된다.
3. 신호를 모은다: OpenTelemetry
OpenTelemetry(OTel)는 텔레메트리를 만들고 보내는 방법의 업계 표준이다. 콘센트 규격처럼, 앱은 표준 플러그로 신호를 내보내고 저장·분석 도구(백엔드)는 나중에 바꿔 끼울 수 있다.
[앱 SDK: 계측] ──OTLP──▶ [Collector: 가공·샘플링] ──▶ [Backend: 저장·분석] 자동/수동 계측 개인정보 제거, 속성 추가 Prometheus, Loki, Tempo, 브라우저 RUM tail sampling, 분배 Jaeger, Datadog, Sentry ...4. 기준을 세운다: SLI / SLO / 에러 버짓
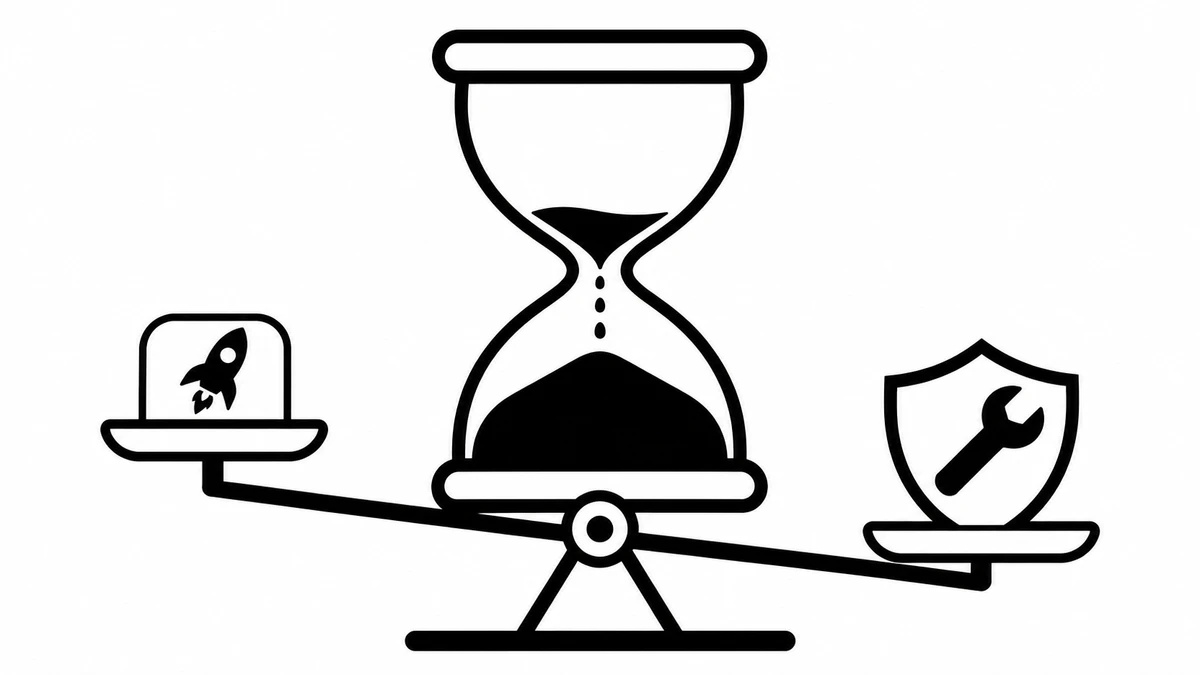
신호를 모아도 기준이 없으면 언제 움직여야 할지 모른다.
- SLI(Service Level Indicator, 지표): 무엇을 잴 것인가 → 예) 요청 중 1초 안에 성공 응답한 비율
- SLO(Service Level Objective, 목표): 그 지표가 얼마여야 하나 → 예) 30일 동안 99.0% 이상
- SLA(Service Level Agreement, 계약): 못 지키면 보상하는 외부 약속
- 에러 버짓: 목표가 허락하는 실패의 양 (100% − SLO) → 30일 요청 100만 건이면 1만 건
에러 버짓이 넉넉하면 과감히 배포하고, 바닥나면 안정화를 우선한다. “빠르게 만들자”와 “안정적으로 하자”의 다툼을 숫자로 중재하는 도구다.
관련 개념 비교
모니터링 vs 옵저버빌리티
| 모니터링 | 옵저버빌리티 | |
|---|---|---|
| 질문 | ”서버가 살아 있나? CPU 80% 넘었나?" | "왜 iOS 사파리에서 공고 상세만, 배포 이후로만 느리지?” |
| 방식 | 미리 만든 대시보드와 임계값 알람 | 속성이 풍부한 신호를 자유롭게 자르고 묶기 |
| 답 | 무엇이 고장 났나 (what) | 왜, 어디서 고장 났나 (why, where) |
| 새 질문이 생기면 | 코드 수정 → 재배포 → 재현 대기 | 이미 쌓인 데이터에 쿼리 |
- 둘은 대체 관계가 아니다. 알람(모니터링)이 먼저 울려야 조사(옵저버빌리티)를 시작할 수 있다.
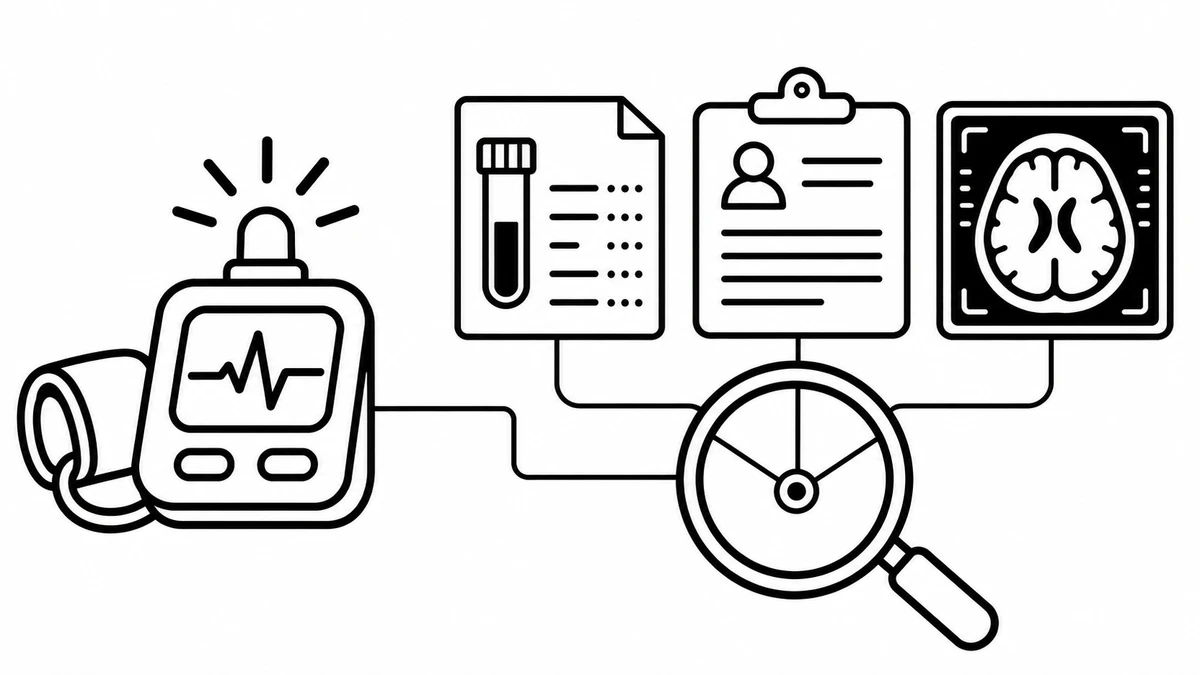
- 비유하자면 모니터링은 혈압계 알람, 옵저버빌리티는 혈액검사·진료기록·MRI를 엮어서 처음 보는 증상의 원인을 찾아가는 일이다.
예시: “공고 상세가 느려요”를 따라가 보기
신호가 서로를 가리키며 범위를 좁혀 가는 흐름이 핵심이다.
| 순서 | 신호 | 알게 된 것 |
|---|---|---|
| 1 | 메트릭 | 공고 상세 p95가 1.84s로 튀었다. 배포 v2.31 직후부터다 |
| 2 | 트레이스 | 1,840ms 중 comments resolver가 1,420ms를 쓴다 |
| 3 | 트레이스 | 그 아래 SELECT user가 24번 순서대로 실행된다. N+1 문제다 |
| 4 | 로그 | 같은 trace_id의 로그에 comment_count: 24. v2.31에서 댓글 작성자 필드가 추가됐다 |
| 5 | 메트릭 + 트레이스 | DataLoader로 묶은 뒤 p95 620ms, 쿼리 1번으로 줄었다 |
2~3번에서 본 트레이스를 직접 눌러 보자. 위쪽 토글로 수정 후와 비교할 수 있다.
- span.name
- resolver comments
- service.name
- api-gateway
- trace_id
- 4bf92f3577b34da6a3ce929d0e0e4736
- duration
- 1,420ms
- graphql.field.path
- comments
- comment.count
- 24
전체 1,840ms 중 1,420ms(77%)를 차지한다. 바로 아래 자식 span을 눌러 원인을 확인해 보자.
알람부터 원인을 찾기까지 코드를 한 줄도 바꾸거나 재배포하지 않았다. 이것이 “관측 가능하다”의 실제 의미다.
이어서: 서버는 고쳤는데 여전히 느리다면
p95를 620ms로 되돌린 뒤에도 “공고 상세가 느리다”는 제보가 이어진다고 해 보자.
서버 트레이스는 서버가 HTML을 응답한 순간 끝난다. 위 트레이스의 620ms 뒤에도 브라우저에서는 이미지를 받고 JS를 실행하는 시간이 이어지지만, 서버는 이 구간을 볼 수 없다.
그래서 실제 사용자 브라우저에서 측정해 보내는 RUM(Real User Monitoring)으로 관측 범위를 브라우저까지 넓힌다. 주로 재는 것은 Core Web Vitals다.
| 지표 | 사용자 입장의 질문 | 좋음 기준 (p75) | 공고 상세에서 나빠지는 예 |
|---|---|---|---|
| LCP(Largest Contentful Paint) | 내용이 언제 보이나? | ≤ 2.5s | 용량이 큰 기업 로고·썸네일 이미지 |
| INP(Interaction to Next Paint) | 눌렀을 때 바로 반응하나? | ≤ 200ms | 스크랩·지원하기 클릭 시 무거운 JS 실행 |
| CLS(Cumulative Layout Shift) | 화면이 갑자기 밀리나? | ≤ 0.1 | 뒤늦게 뜬 배너가 본문을 아래로 밀어냄 |
import { onLCP } from "web-vitals";
onLCP((metric) => {  navigator.sendBeacon(    "/rum",    JSON.stringify({      name: metric.name,      value: metric.value,      page: location.pathname, // 나중에 자르고 묶을 기준    }),  );});
측정값만 보내면 “LCP가 나쁘다”까지만 알 수 있다.
측정값과 함께 page 같은 기준을 보내야 “공고 상세에서만 LCP가 4초”처럼 범위를 좁힐 수 있다.
예시 코드
수동 span 만들기 (OTel API)
import { trace, SpanStatusCode } from "@opentelemetry/api";
const tracer = trace.getTracer("activity-detail");
export async function getComments(activityId: string) {  return tracer.startActiveSpan("resolver comments", async (span) => {    span.setAttribute("activity.id", activityId); // 나중에 이 값으로 자르고 묶을 수 있다
    try {      const comments = await db.comment.findMany({ activityId });      span.setAttribute("comment.count", comments.length);
      return comments;    } catch (error) {      span.recordException(error as Error);      span.setStatus({ code: SpanStatusCode.ERROR });
      throw error;    } finally {      span.end(); // 끝을 찍어야 duration이 생긴다    }  });}
로그: 문장이 아니라 필드로 남긴다
공고 상세가 느린 상황에서 이런 질문이 떠오른다고 해 보자.
“댓글이 20개 넘는 공고만 느린 걸까?”
로그가 사람이 읽는 문장이라면 이 질문에 답하기 어렵다.
[WARN] comments slow for activity 183920 (1420ms)[WARN] activity 183921 comments took 980ms, count=31[WARN] slow comments: id=183925- 개발자마다 문장 모양이 달라서, 댓글 수를 뽑으려면 줄마다 다른 정규식을 짜야 한다.
- 어떤 줄에는 댓글 수가 아예 없다.
- 이 로그가 어느 요청에서 나왔는지 알 수 없어서 트레이스와 연결할 수 없다.
같은 내용을 필드로 남기면 로그가 표의 한 행처럼 바뀐다.
{ "level": "warn", "msg": "comments slow", "activity_id": "183920", "comment_count": 24, "duration_ms": 1420, "trace_id": "4bf92f3577b34da6a3ce929d0e0e4736"}이제 질문이 곧 쿼리가 된다.
| 질문 | 조건 |
|---|---|
| 댓글이 20개 넘는 공고만 느린가? | comment_count > 20 |
| 1초 넘게 걸린 공고는 몇 개인가? | duration_ms > 1000을 activity_id별로 세기 |
| 이 로그를 남긴 요청은 어디서 시간을 썼나? | trace_id로 트레이스 열기 |
마지막 줄이 핵심이다.
로그에 trace_id가 있으면 로그 한 줄에서 그 요청의 전체 여정으로 바로 넘어갈 수 있다.
헷갈리기 쉬운 부분
오해: 데이터가 많으면 관측 가능하다
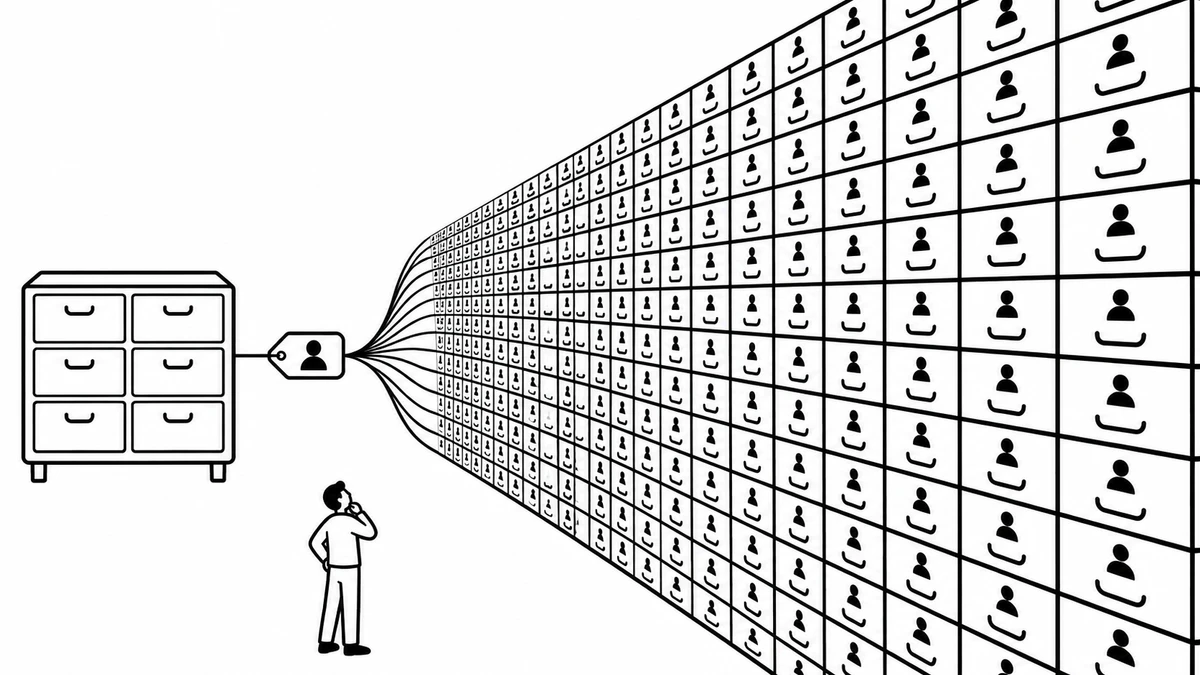
- 카디널리티 폭발: 메트릭은 라벨 조합마다 시계열이 생긴다.
route(50) × method(4) × status(10)= 2,000개는 괜찮지만, 여기에user_id(100만)를 곱하면 20억 개가 된다. user_id 같은 고유 값은 메트릭 라벨이 아니라 트레이스·로그 속성에 넣는다. - 모든 걸 로그로: 세는 건 메트릭, 흐름은 트레이스, 사건의 상세만 로그로.
- 연결 고리 없음: 세 신호를 각기 다른 도구에 두고 trace_id를 안 넣으면, 세 화면을 시간으로 눈대중 맞추게 된다.
오해: 평균이 괜찮으면 괜찮다
- 평균 300ms 뒤에 p99 5초가 숨는다. 지연은 p50 / p95 / p99 백분위로 본다.
샘플링: head vs tail
- head sampling: 요청 시작 시점에 남길지 정한다. 싸지만, 1%만 남기면 드문 에러 트레이스가 사라진다.
- tail sampling: 요청이 끝난 뒤 정한다. Collector에서 에러·느린 요청은 항상 남기고 정상 요청만 덜어낸다.
알람은 원인이 아니라 증상에 건다
- “CPU 70%” 같은 원인 기반 알람이 매일 울리면 알람 피로로 아무도 안 보게 된다.
- 사용자가 실제로 겪는 증상, 즉 SLO 소진 속도(burn rate)에 알람을 건다.
개념 정리
옵저버빌리티는 시스템이 밖으로 내보내는 신호만 보고 내부에서 무슨 일이 일어나는지 설명할 수 있는 능력입니다. 원래는 제어 이론에서 온 개념으로, 출력만으로 내부 상태를 추론할 수 있으면 관측 가능하다고 말합니다.
모니터링과 자주 비교되는데, 모니터링은 “CPU가 80%를 넘었나”처럼 미리 정한 질문에 답합니다. 반면 옵저버빌리티는 “왜 특정 페이지에서만, 배포 이후로만 느린가”처럼 아직 아무도 묻지 않은 질문에도 코드를 다시 배포하지 않고 답할 수 있게 해 줍니다. 둘은 대체 관계가 아니라, 알람이 울린 이후 원인을 찾는 시간을 줄이는 확장 관계입니다.
이를 위해 세 가지 신호를 사용합니다. 메트릭은 집계된 숫자로 “평소와 다른가”를 싸고 빠르게 알려 주고, 로그는 개별 사건의 상세를, 트레이스는 요청 하나가 여러 서비스를 거쳐 가는 여정과 구간별 소요 시간을 보여 줍니다.
중요한 것은 셋이 따로 있는 게 아니라 trace_id로 서로 연결되어야 한다는 점입니다.
서비스 경계를 넘을 때 traceparent 헤더로 컨텍스트를 전파하고, 로그에도 같은 trace_id를 넣으면 메트릭의 이상 지점에서 트레이스로, 트레이스에서 로그로 범위를 좁혀 갈 수 있습니다.
수집은 보통 OpenTelemetry라는 표준으로 하는데, 벤더에 묶이지 않고 Collector에서 개인정보 제거나 tail sampling 같은 가공을 할 수 있습니다. 그리고 SLO와 에러 버짓으로 “얼마나 좋아야 충분한가”를 숫자로 정해, 알람 기준과 배포 속도의 균형을 잡습니다.
핵심 문장
- 모니터링은 미리 정한 질문에, 옵저버빌리티는 처음 보는 질문에 재배포 없이 답하게 해 준다
- 메트릭은 “무엇이”, 트레이스는 “어디서”, 로그는 “그때 무슨 일이”를 답하고, trace_id가 셋을 잇는다
- 데이터의 양이 아니라 신호 사이의 연결과 자르고 묶을 수 있는 속성이 관측 가능성을 만든다
기타
꼬리 질문
- Q. 회원 ID별 응답 시간을 보고 싶다. 메트릭 라벨에 user_id를 넣어도 될까?
- 안 된다. 카디널리티가 폭발한다. span 속성이나 로그 필드에 넣고 거기서 필터한다.
- Q. 서버 p95는 정상인데 사용자 불만이 늘었다. 무엇을 먼저 의심하나?
- 서버 밖 구간. RUM의 LCP·INP를 기기·브라우저·페이지별로 나눠 보고, 클라이언트 JS 에러와 CDN·이미지 지연을 확인한다.
- Q. Next.js 서버에서 API로 간 요청이 트레이스에서 따로 떨어져 보인다. 왜일까?
- Context propagation이 끊겼다. HTTP 클라이언트가
traceparent헤더를 안 보내거나, 받는 쪽이 읽지 않는다. 자동 계측이 그 클라이언트를 감싸는지 확인한다.
- Context propagation이 끊겼다. HTTP 클라이언트가
- Q. SLO 99.9%, 한 달 요청 300만 건이면 허용되는 실패 요청은?
- 3,000,000 × 0.001 = 3,000건.
- Q. Lighthouse로 재면 RUM은 필요 없지 않나?
- Lighthouse는 정해진 기기·망에서 재서 재현이 쉽고 배포 전후 비교에 좋다. RUM은 실제 사용자의 저사양 기기·느린 망 같은 꼬리를 보여 준다. 배포 전에는 Lighthouse로 거르고, 배포 후에는 RUM으로 확인한다.
- Q. “세 기둥”만 갖추면 옵저버빌리티를 달성한 걸까?
- 세 기둥은 데이터 형태일 뿐 목표가 아니다. 한 요청에 대한 풍부한 속성(높은 카디널리티)을 담은 이벤트를 남기고, 그걸 자유롭게 자르고 묶을 수 있어야 한다는 관점(wide events)도 있다.
용어
- Instrumentation(계측): 코드가 텔레메트리를 내보내도록 SDK나 코드를 넣는 일
- Exemplar: 메트릭 데이터 점에 붙은 대표 trace-id
- OTLP: OpenTelemetry Protocol. SDK·Collector·백엔드 사이의 전송 규격
- MTTR: Mean Time To Resolve(Recover). 장애 인지부터 복구까지의 평균 시간